演化的支点
《Dive into Deep Learning》笔记
Intro #
读 D2L 完全是因为缺乏 CS336 Architecture 的前置知识,来补课
在此之前我写过 LeNet 的 Lab(尽管是 vibe 的),带有基础理解
重点读 模型架构部分,推导和代码略读
严格来说这是我第一次粗读后的回顾,旨在梳理 model 发展的脉络,从中提取有价值的启发性知识
受限于本书内容,不会讨论 Transformer 后的现代架构
Ch1、Ch2 #
首先讲一下我对 机器学习 的理解
我认为现代的 ML 是基于 数据统计 方法构建起来的,而非 符号分析 方法
这确定了 Data 的主导地位,也使得 模型 具有极大的 通用性
传统的研究方法,是侧重于数据集,认为 手工提取特征 更加重要。而现代的目标是 构建端到端系统,让模型自动地学习特征
那么这种 model 的本质是什么呢?
我认为本质是 ”模型 -> 求 loss -> 调参“ 的流程,用无穷尽的参数组合 来 拟合 目标函数
这里有一个默认前提,我们认为 任何计算过程 都可以构造一个函数 $f$ 进行逼近
model 涉及 “如何组织参数” 的问题:$f$ 很可能无法用数学语言直接描述,或者说现有的表达力不足,这需要我们引入一些启发式机制(RNN、attention)对其进行表达
求 loss 涉及到 “如何加速计算” 的问题:$f$ 的训练需要多次计算 loss 以调整,然而手工编写计算过程引入了不必要的复杂度,并且在并行效率上也显然不足,这需要我们引入相应的 软件框架(tensor 抽象) 与 硬件支持(GPU)
调参 涉及 “如何控制成本” 的问题:$f$ 的梯度下降是有尺度的,过大过小都会导致难以收敛,这需要我们从架构层面对数值进行限制(Norm,优化手段)
以上就是我们打算谈论的三个话题:机制、计算、数值
这也对应我们的预备知识:
- 开发框架 用于隐藏底层抽象
- 线性代数 用于表达批量计算
- 微积分 用于数值分析,调整参数
而剩余的 model 部分则是 ML 特有的知识
Ch3 单层线性网络 #
回到基本的统计模型:回归问题
假设 房价 $y$ 与 面积 $x$ 存在线性关系 $y = w x + b$ ,给定 $N$ 对数据集 $(x_i, y_i)$,试确定参数 $w,b$
线性关系就是我们对 $f$ 的 model 描述 ,求残差就是求 loss,用梯度下降调参
这相当于一个单层神经网络,$w$ 是权重
下文均忽略偏置项 $b$,它可以视作 $x = 1, w = b$ 的特例
将 $x$ 替换成向量 $X = (x_1, x_2, … , x_n)$,$w$ 同理,那么 $Y = f(X) = WX$
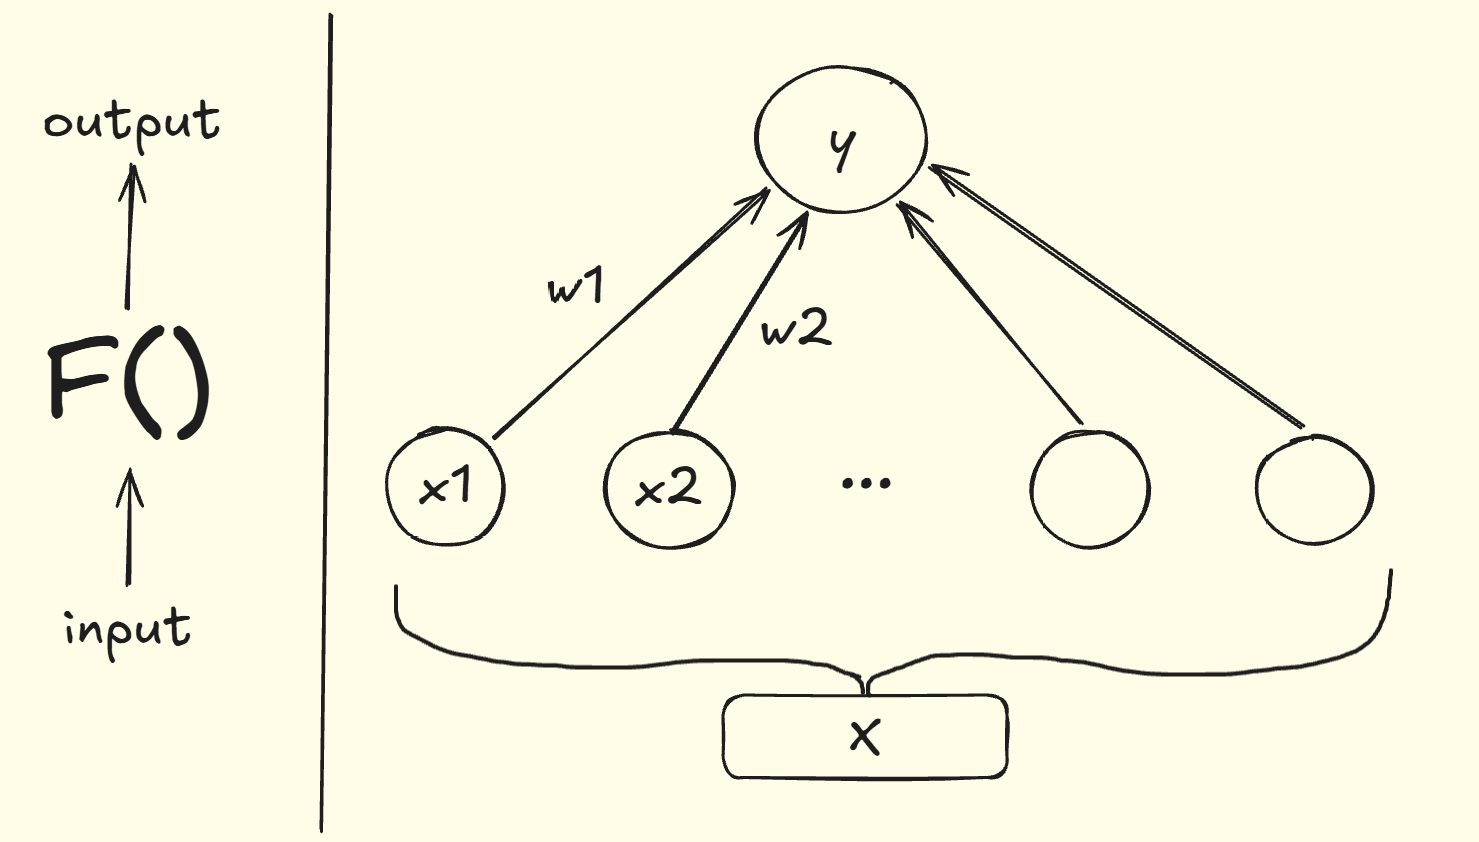
处理分类问题,我们引入 softmax 运算 ,表达识别结果
$$\operatorname{softmax}(\mathbf{y}) _ {i} = \frac{e^{y _ i}}{\sum_{j=1}^{N}e^{y_j}}$$
$P(y_1 | X)$ 表示输入为 $X$ 时,model 认为类别为 $y1$ 的概率
这样我们就用向量 $Y$ 对分类结果完成了编码
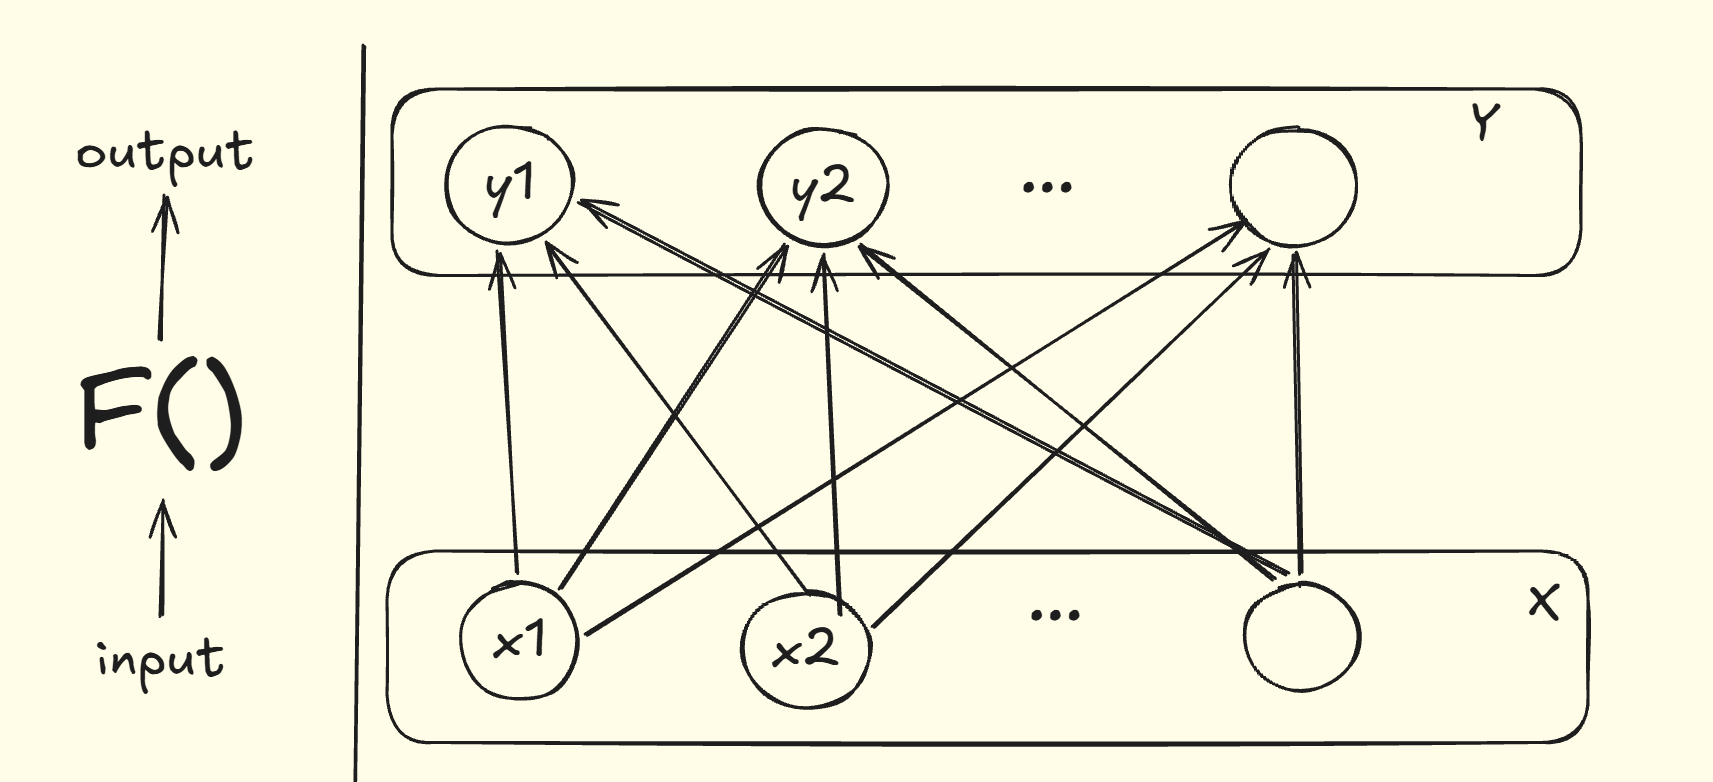
考虑 计算 和 数值
计算上:
- 全连接层的复杂度是平方级别 $O(n^2)$,我们可以分 k 组连接,优化到 $O(\frac{n^2}{k})$
- 引入 batch,一次 train 同时输入 n 个向量 X,那么 $X \in \mathbb{R}^{n \times d}$ 在物理上多一维,可以利用 GPU 进行并行计算
数值上:
- 采用交叉熵损失
- 指数运算可能溢出,需要控制计算细节
Ch4 多层网络 #
显然线性 model 的表达力不足,如果我们加深网络层数,就可以表达曲线
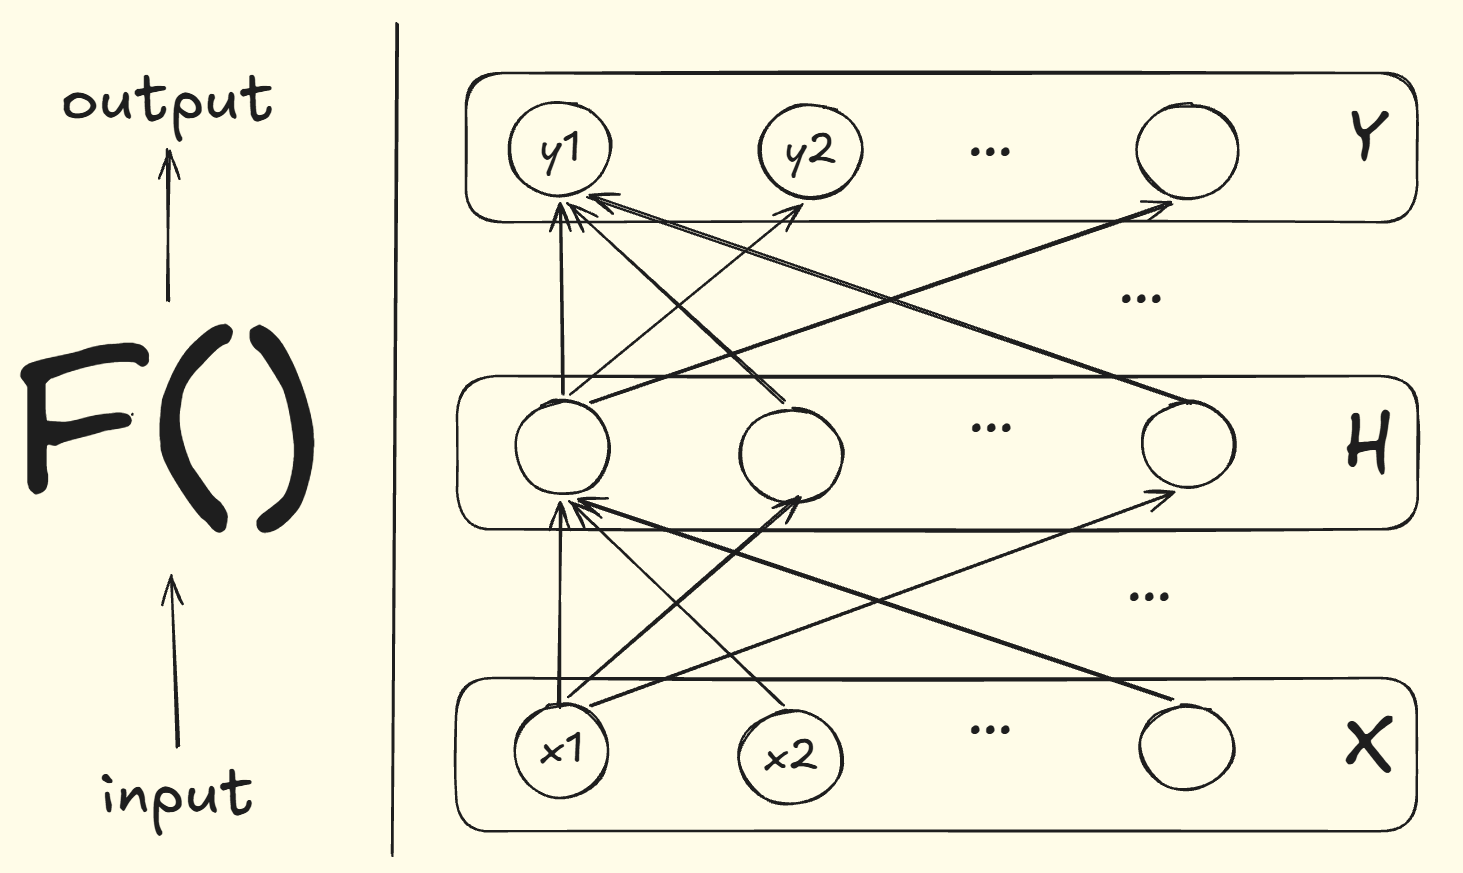
线性套线性不会提升表达力 $$ y = w_1h = w_1(w_2x) = wx $$ 我们在 H 层 引入激活函数(ReLu、Sigmod、Tanh)后,就可以表达非线性函数了,这称为多层感知机(MLP)
泰勒展开 得到 近似多项式函数,用 激活函数 线性组合出 各项系数
然而表达力太强也有缺点,这会导致模型过拟合,缺乏泛化能力
如果数据集足够大,大到过拟合 = 100% correct,这就是优点了
考虑 数值:
为处理过拟合,我们引入权重衰减,正则化超参数 $\lambda$ $$ L_{\text{reg}}(\mathbf{W}) = L(\mathbf{W}) + \frac{\lambda}{2} |\mathbf{W}|_2^2 $$ 这给梯度加入了”弹性“
- 如果 $W$ 增长过快,L2 惩罚项会迅速拉大 loss,使其放缓速度
- 如果 loss = 0,这显然过拟合了,L2 惩罚项会强迫模型离开极值点
Q:这里的惩罚项会让 $W$ 向 0 逼近,这种倾向不会影响模型能力吗?
A: 我们先假设 $W$ 服从均值为 $0$ 的高斯分布 $$ p(\mathbf{W}) = \frac{1}{(2\pi\sigma^2)^{d/2}} \exp\left(-\frac{|\mathbf{W}|^2}{2\sigma^2}\right) $$ 这是一个先验事件 $W$,训练结果看作事件 $B$,那么它对应的概率就是 $P(B|W)$,我们的目的是让后验概率 $P(W|B)$ 最大,取负对数 可以证明它等价于 $L_{reg}(W)$ 最小,因此是合理的
既然 MLP 容易过拟合,那么我们可以给数据下毒,故意扰乱它的训练,逼迫它学习泛化特征,这就是 Dropout 的想法
我们让神经元 h 以 $p$ 的概率被丢弃,$(1-p)$ 的概率调整为 $\frac{h}{1-p}$,这样模型的各个部分就不得不学会独立工作,权重会被分散到整个网络中(而不是依赖同一层单元之间的联动)
$E(h)=h$ 保持不变,不影响训练
计算上,开发框架提供 前向和反向传播 的接口,用计算图为中间变量分配内存
有关环境偏移的部分,因与学习主题关联不大,跳过
Ch6、Ch7 卷积网络 #
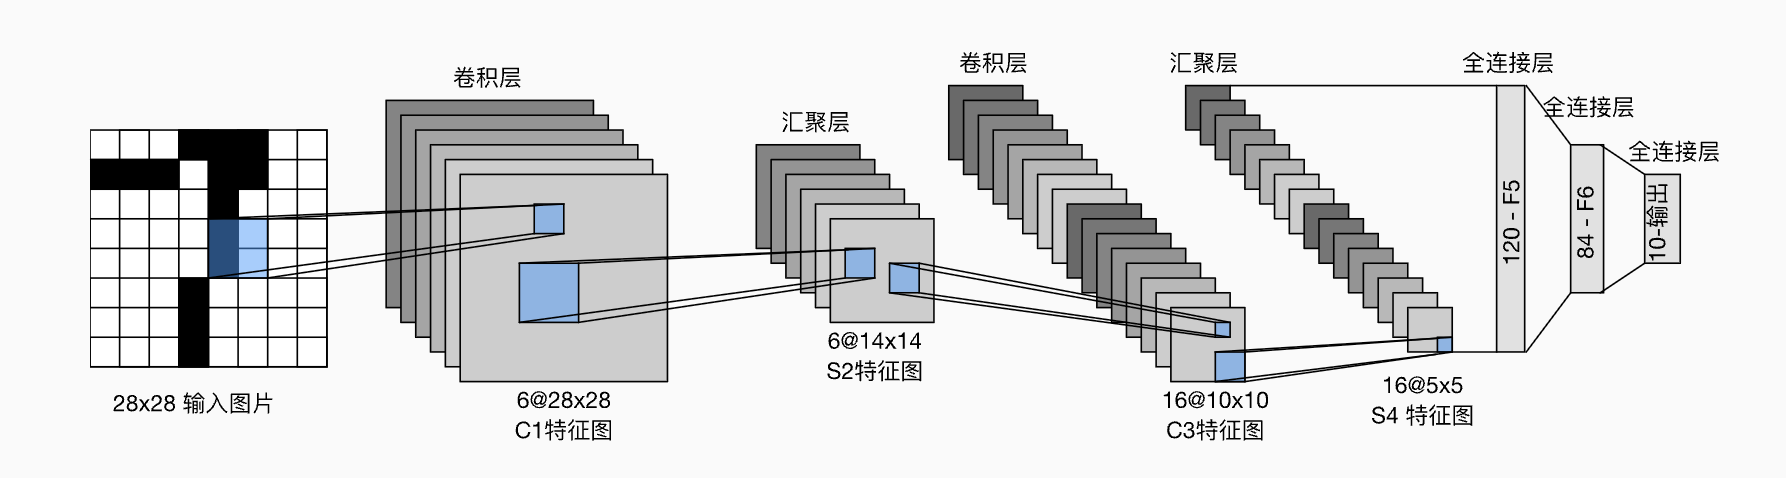
上图为 LeNet 架构,我们用卷积层来表达空间关系,并用填充、池化、多通道等技巧增加信息密度,调整卷积核参数,就得到了卷积神经网络(CNN)
严格来说应该是互相关运算,通过下式传播梯度 $$ Y_{i,j} = \sum_{c} \sum_{u,v} X_{c,i+u,j+v} , W_{c,u,v} + b $$
AlexNet 是一个加深的 LeNet
数据集与算力发展的共同作用下,深度学习发展的条件已经成熟,人们可以训练极深的网络,而不必担心算力或训练集不足,规模化则催生出 best practice
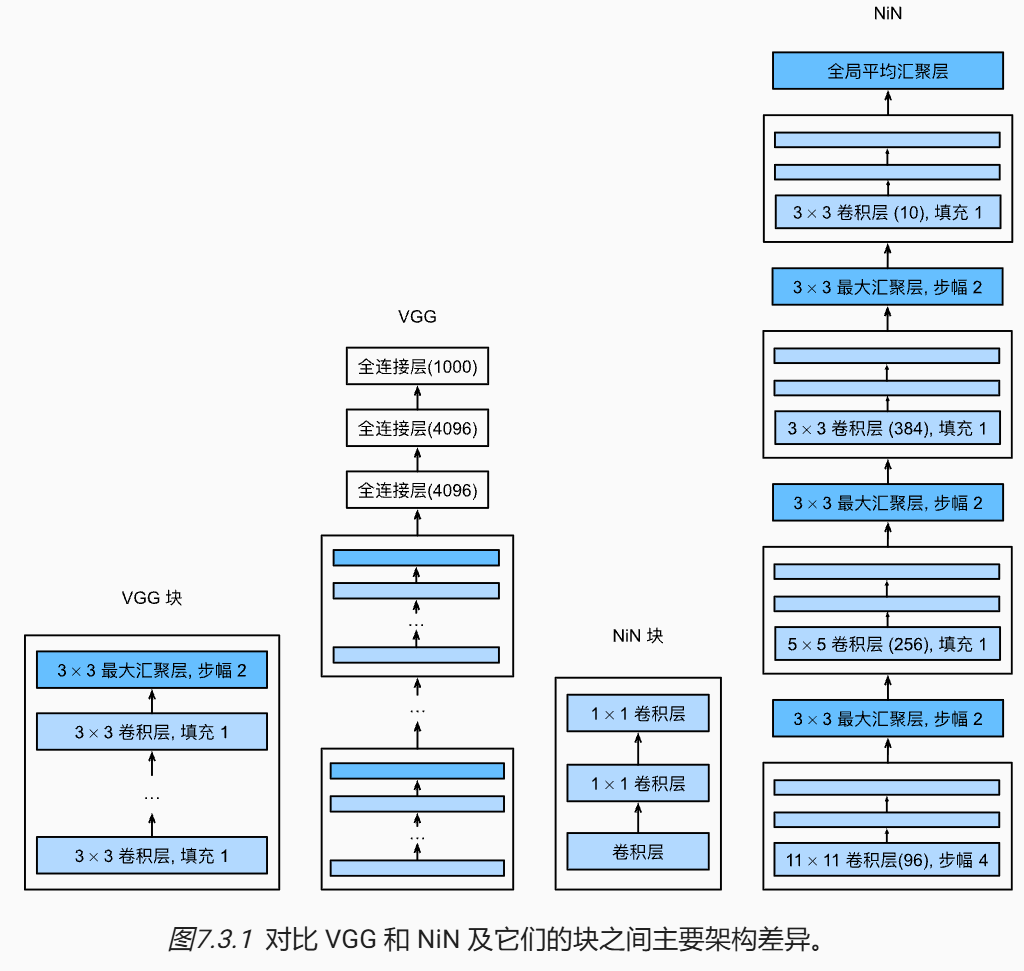
VGG 和 NiN 的想法是 按 block 封装卷积层,减轻心智负担
VGG 块侧重卷积深度,方便复用;而NiN 块侧重局部特征,更像是在每个像素通道上,建立了一个 $1 \times 1$ 的子网络并联执行
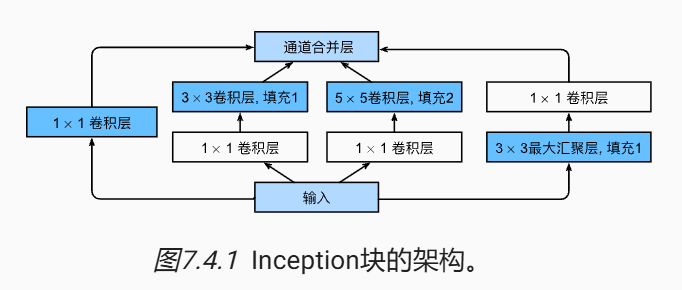
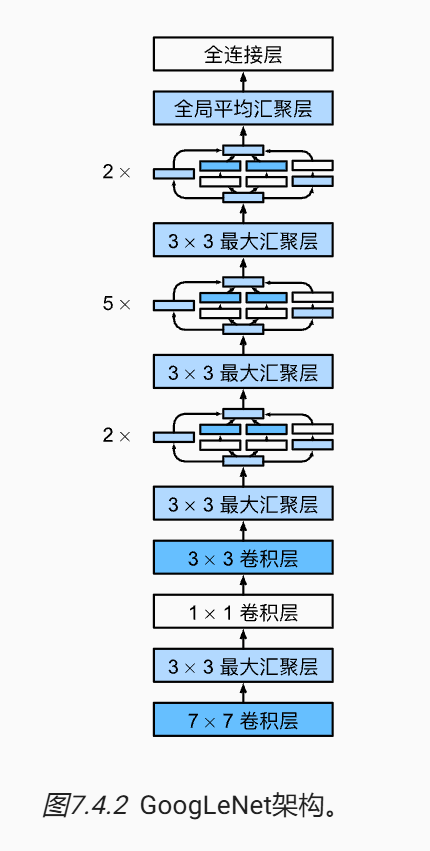
GoogLeNet 则是用了并联的 Inception 块,选择"我全都要",将不同的卷积核组合到一起作用
数值上,网络规模的扩大迫使人们开始追求稳定性,原有的设计存在梯度消失、梯度爆炸问题,这源于各个层次间的数据尺度不一致,因此进行规范化是一个很符合直觉的选择,如 Batch Normailzaion,这使得 Norm 层开始流行
深度增加,模型的能力却不一定变强,因为能表达的函数集合并不是单调增长的
回顾之前的改进,我们似乎都在做同一件事情:让不同的子网并联运行。但是这么做不够彻底,还是没能点出“单调增长”这一主题。用串联表达并联网络,这就是 ResNet 的想法
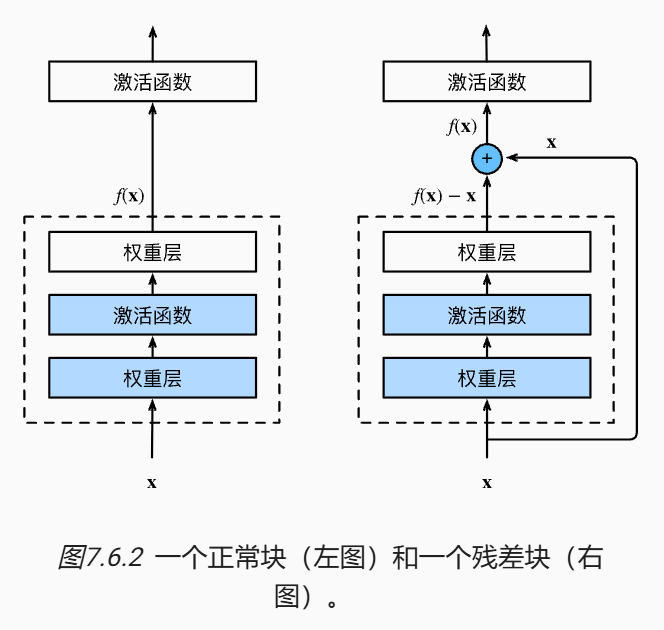
ResNet 引入残差块,让中间层去拟合 $f(x) - x$
我们可以换个视角,令 $f_1(x) = x, f_2(x) = f(x) - x$,那么有 $$ f(x) = f_1(x) + f_2(x) $$ 别忘记 $x$ 是上一层网络的输出,本身就套了一层映射,那么这本质上就是用两个网络分别拟合 $f_1$ 和 $f_2$ ,只不过由于串联的形式,更靠近输入的 $f_1$ 会先得到充分训练,$f_2$ 的拟合尺度则更小
无残差设计相当于训练 $f(x) = f_1(y) = f_1(f_2(x))$ ,深度越大,接收到的输入信息就越失真,收敛慢,同时不利于梯度的传播
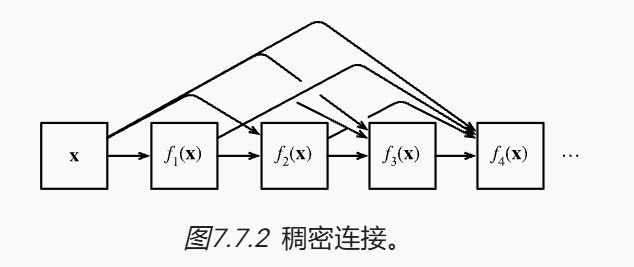
而后续的 DenseNet 则更加激进,直接显式连接了所有并联的子网,相应地,其规模也更小,还需要增加过滤层来控制通道数量,但这是给稠密连接的表达力让路
Ch8、Ch9 循环网络 #
处理语言预测问题,我们引入序列模型
给定序列 $x_1, x_2, … x_t$ 预测 $x_{t+1}$ 的值
两种方式:
- 考虑全局信息,认为 $y = f(x_1, x_2, …, x_t)$
- 考虑局部信息,认为 $y = f(x_{t-len+1}, … x_{t})$
前者的 input 是变长的,不能用常规网络训练,需要用隐状态描述序列信息,引入循环神经网络 RNN,用 softmax 层输出预测结果
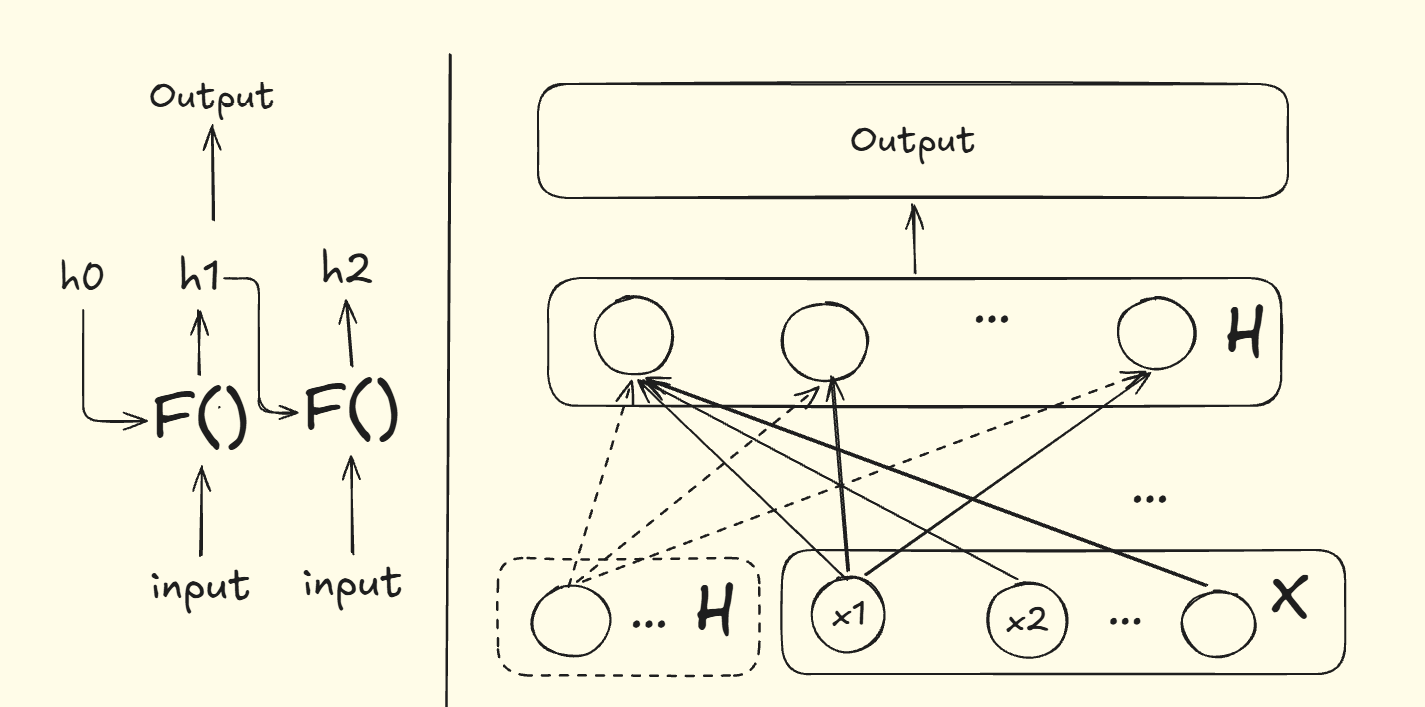
对长序列数据的batch,我们采用 随机划分 或 顺序交叉划分
从计算上来说 $H_{t}$ 依赖于 $H_{t-1}$ ,这导致其梯度也 递归地 依赖于 $t-1$ 时刻的计算结果。尽管我们用隐状态保证参数是定量的,但是计算过程仍是变长的,这不仅会使得计算时间变长,还存在梯度爆炸问题。
为了方便,我们会选择一个时刻强行截断递归(随机或定长),将计算长度保持在可控范围,这样训练时间就可以接受了
然而 RNN 相当于在时间序列上 加深度,仍然存在信息失真的问题,为此我们又增加单独的控制单元,来改变隐状态的继承权重,这就是 GRU 与 LSTM 的想法
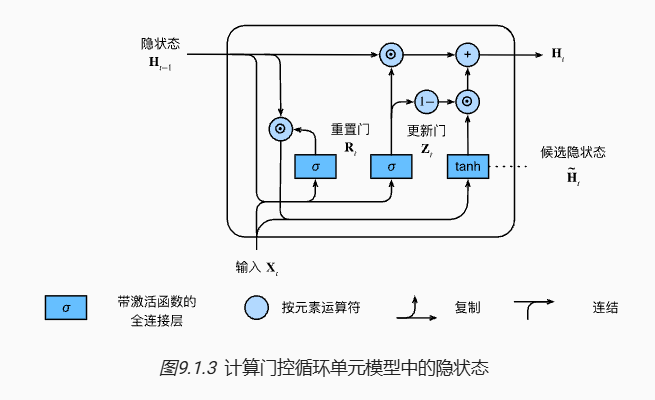
此外还存在深度 RNN 与双向 RNN 的变种,逐层训练,先横向传播隐状态,再向下一层训练
用两个 RNN 实现 Encoder 和 Decoder,即可处理 seq2seq 翻译任务,其中 Encoder 读取序列,生成隐状态,Decoder 对隐状态解码,生成输出序列
Ch10 注意力机制 #
基于隐状态的表达仍然不足。为解决信息失真,我们引入注意力机制。
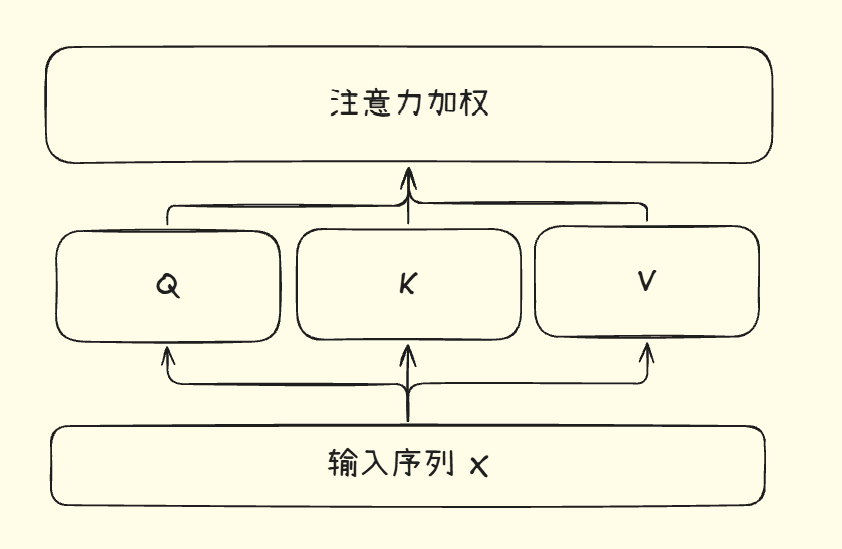
我们将输入映射到向量 Q、K、V,然后对 QK 做关联运算,加一个softmax层,计算出对应 V 的权重,得到注意力加权后的输出
这里我们针对 Q 做 softmax,表达是以 Q 为关键字,计算与每个索引 K 的关联,最后针对状态 V 做加权,输出 context 状态 C,三者学习到的特征不同
将其融入到 RNN :Decoder 可以以前一时刻的隐状态作为 Q,之前所有的状态序列作为 KV,引入注意力块,得到上下文状态 C,再与隐状态 H 加权完成预测
然而 RNN 的瓶颈在于递归依赖,只要还使用隐状态机制,我们就不能避免低效的串行计算,因此 transformer 抛弃了 RNN 转向纯注意力机制
我们可以将输入 X 直接映射到 QKV(而不是状态 H ),这就是自注意力的想法
让 X 映射到多组 QKV,最后映射到同一个 C,这是多头注意力的做法
另外,纯注意力丧失了 RNN 固有的依赖关系,我们需要引入位置编码,以表达不同位置之间的关联特征
注意力只是用于提取上下文状态,再加入多层 MLP 学习特征,用 残差块 和 Norm块 加速收敛,就得到了 Transformer
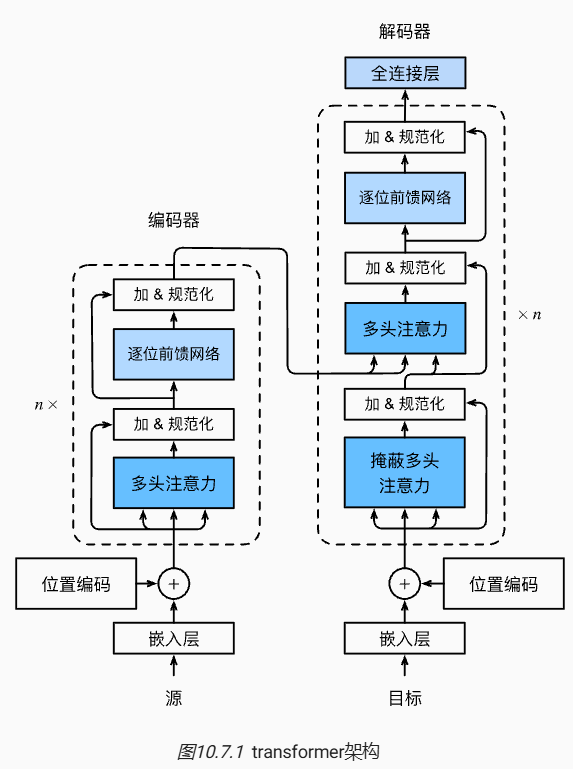
Decoder 用于预测下一个 token,是自回归的,因此它的输入需要加掩码,填充位置,保证靠后的位置不参与注意力机制
而前馈网络 FFN 就是两层 MLP,注意到输入 X 是一个 $t \times d$ 的序列矩阵,这怎么输入到 MLP 呢?
这里我们用到了一个技巧,让 MLP 针对每个位置 $x_t$ 做重复映射,最后合并,类似于 NiN 块的宽度想法
我们认为 可提取的特征 是 位置无关 的,因此每个 $x_t$ 共用同一组 MLP 参数矩阵,而不同 Transformer 块的 FFN 参数则是独立的
从计算上,纯注意力机制一次性输入整个序列,这使得我们一开始就具备所有计算的前提条件,不存在同步锁,因此是可以并行的。另外长序列的复杂度是 $O({n^2}d)$ 的,对算力的要求更高
架构上,transformer 成功表达了长距离依赖的关系;而数值上通过我们之前的参照、缩放、normalization 等手段加速收敛,从而成为一个可用的模型
另外 Decoder 的自回归机制,导致我们在推理时需要对 attention 进行重复计算,这也引出了 KVCache 的优化手段
有关 Transformer 之后的话题 ,这里只列出关键词:
- 稀疏注意力,线性注意力、Mamba、MoE
- FlashAttention、KV Cache、并行、梯度检查点
- Pre-LN、RMSNorm、GELU、BF16
参数越多,表达力越强,但 Attention 机制叠加深层网络,这样的计算强度是我们无法接受的。既然如此,我们改为并联网络,每次只激活几个子网,既能提升表达力,又限制了计算成本
这就是 MoE 的做法,它引入了路由机制,添加一个轻量的路由层,给输入 X 进行评分,并激活对应的 top-K 子网,其他子网不使用,这就支持了大量的并联 FFN 参数
相应的, MoE 也提供了路由算法的研究空间
而 Mamba 的想法和 Transformer 是独立的,它源于 SSM 模型,仍采用状态机制来表达上下文(而不是注意力机制)
在 RNN 中,$h_t = f(x_t, h_{t-1})$ 是一个非线性函数,这强制我们串行计算
而 Mamba 将其弱化为 $h_t = Ah_{t-1} + Bx_t$,这使得我们可以采用并行算法
我们添加类似 QKV 的映射子网,让 $x_t$ 动态决定 $A,B,C$ 等参数矩阵的内容,这就弥补了 线性转移 所损失的表达力
这样训练时,我们可以一次输入整个序列,并行计算,推理时则朴素串行,相对 Transformer $O(n^2)$ 的推理复杂度,Mamba 的线性推理更加稳定
Ch11 优化算法 #
我们用 梯度下降 进行调参:
- 引入学习率,控制调整尺度
- SGD 引入随机化噪声,加速计算
- Mini-batch 引入 batch,做折中
- Momentum 引入动量,让历史趋势影响学习率,提升惯性
- AdaGrad 引入自适应机制,让每个参数都自己调整学习率
- RMSProp 改进了 AdaGrad 的累加形式,用指数形式平滑学习率
- Adadelta 是 RMSProp 的变体,抛弃手动参数,追求完全自适应
- Adam 是 Momentum + RMSProp 的结合
- 学习率调度器 引入阶段概念,在训练的不同时刻,自动调整学习率
Summary #
梳理之后,我大致建立了对网络架构的直觉,有关具体实现、数学推导、优化方法等并未深入实践,后续的章节不再阅读